
Las Redes Neuronales son un modelo de Machine Learning que se inspira en la manera en que funciona el cerebro humano, una compleja red de miles de millones de neuronas altamente interconectadas. La comunicación entre estas neuronas es lo que nos permite procesar información, aprender y experimentar el mundo que nos rodea. Si la señal es lo suficientemente fuerte (potencial de acción), la neurona se activa y transmite una señal eléctrica a través del axón hacia las neuronas cercanas mediante un proceso denominado sinapsis.

Las Redes Neuronales Artificiales (ANN), también denominadas Redes Neuronales a secas, están compuestas por múltiples capas, cada una compuesta por el equivalente a una neurona. En el contexto del Machine Learning (ML) estas neuronas también reciben el nombre de perceptrones.

Cada perceptrón recibe información o bien directamente de la capa de entradas externas (inputs) o bien de los otros perceptrones presentes en la capa previa. El perceptrón recibe la información, la procesa y a continuación la envía a los otros perceptrones presentes en la siguiente capa o, si estamos en la última capa, a la capa de salida directamente (output). Puedes ver estas conexiones destacadas en amarillo en el gráfico anterior.
Se denominan capas ocultas a todas aquellas capas con las que no interactuamos directamente, es decir, ni vemos ni controlamos lo que entra en ellas ni el output que generan.

Las Redes Neuronales en las que todas la capas adyacentes están completamente conectadas, es decir, cada perceptrón de la capa previa está conectado con todos los perceptrones de la siguiente capa, y a su vez recibe conexiones de todos los perceptrones de la capa anterior, se le denomina también un Perceptrón Multi-capa (MLP).
La profundidad de la Red depende del número de capas ocultas que contiene entre la capa de entrada (input) y la de salida (output). Como regla general cuanto más profunda sea la red, más capas tenga, mayor será la capacidad del modelo para ajustarse a los datos de entrenamiento. Pero esto no tiene porque ser necesariamente bueno debido a que corremos el riesgo de que la red puede ajustarse tanto a los datos de entrenamiento que luego no logre generalizar cuando le mostremos datos nuevos. A esto se le denomina sobreajuste (overfit). Adicionalmente a mayor complejidad de la red mayor será también el consumo de recursos computacionales y, por lo tanto, también los costes de entrenar nuestra red.
Normalmente cuando una red neuronal está compuesta de dos o más capas ocultas se habla de una Red Neuronal Profunda (Deep Neural Network).
El número de capas y de perceptrones de cada capa son hiperparámetros que se definen a nivel de la arquitectura de la red. Un hiperparámetro es un tipo de parámetro que se configura antes de iniciar el proceso de entrenamiento para definir la arquitectura y el modelo de aprendizaje.
Es importante entender que los hiperparámetros son un tipo de parámetro diferente de los parámetros que se ajustan durante el proceso de entrenamiento. A pesar de ello se trata de componentes que tienen una influencia relevante en la capacidad de la red para aprender de manera efectiva y de poder generalizar adecuadamente sus aprendizajes cuando se enfrente e nuevos datos.
¿Qué es un Perceptrón?
El inventor del Perceptrón es Frank Rosenblatt, nacido en la ciudad de Nueva York en 1928 y fallecido el día de su 41 cumpleaños en un desafortunado accidente mientras navegaba por la Bahía de Chesapeake. A pesar de su temprana muerte realizó una gran labor de investigación como psicólogo en la Universidad de Cornell. Gracias a su trabajo es considerado uno de los padres fundadores de la inteligencia artificial.
Su trabajo más importante fue el desarrollo del Perceptrón, un modelo computacional inspirado en el funcionamiento de las neuronas del cerebro humano.

El Perceptrón, presentado en 1958, fue la primera red neuronal artificial capaz de aprender mediante un algoritmo de ajuste de pesos. El modelo original de Rosenblatt era capaz de aprender a realizar tareas de clasificación como las usadas hoy en día para evaluar si un correo es spam por ejemplo. Pero el perceptrón de Rosenblatt tenía una limitación: solo podía tomar decisiones sobre datos con relaciones lineales, es decir, donde los datos pudieran separarse usando una línea. Pero la realidad de los datos es demasiado compleja para poder modelar los datos adecuadamente solo con una línea.
El concepto detrás del perceptrón es sencillo. Podemos pensar en él como una neurona artificial individual que recibe información de distintas entradas o inputs: $ x_1, x_2..x_m $. Para emular el funcionamiento de las neuronas biológicas, esta neurona artificial realiza dos funciones consecutivas: primero calcula la suma ajustada por los pesos de las entradas, un proceso a través del que modula la intensidad de las diferentes señales recibidas como inputs. Y, en segundo lugar, aplica una función no lineal al resultado anterior que, simplificando, funciona a modo de umbral para determinar si el output se va a activar o no.
No todas las señales de entrada son igual de importantes, los pesos actúan como una especie de diales que transmiten y modulan la importancia de la señal de entrada de cada capa. Un peso elevado amplificará la señal de entrada mientras que un peso bajo la reducirá.

Ese es el motivo por el que cada input, incluido el sesgo, va a tener un peso diferente $ w_1, w_2… w_m $, que reflejará su importancia relativa en el proceso de aprendizaje.

La sección de la función lineal define una línea recta que está representada por la suma de los pesos para cada valor de $ x_i $ a la que se suma el sesgo $ b $, que será la intersección de la línea con el eje y. Si variamos el valor de $ b $ cambiaremos la altura a la que la recta cruza con el eje y. Sin este valor la recta estaría siempre obligada a pasar por el origen $ (0,0) $ por lo que sería imposible separar los datos con una recta.

La función de activación: una función no lineal
He dicho que el resultado de la suma ponderada más el sesgo se pasa finalmente por una función no lineal. Existen multitud de funciones no lineales. La Sigmoidea, también llamada función en S por su característica forma, es una de las más utilizadas porque es capaz de tomar un input de cualquier valor, por grande o pequeño que sea, y comprimirlo a un valor entre 0 y 1.
Pero, en el caso de los perceptrones y las Redes Neuronales, la función más habitual es la Unidad Lineal Rectificada (ReLU por sus siglas en inglés). Entre los motivos para usar ReLU está su simplicidad, devuelve el valor de entrada si es positivo y 0 en caso contrario, lo que la hace muy eficiente desde el punto de vista computacional ya que para todos los imputs negativos devolverá 0.
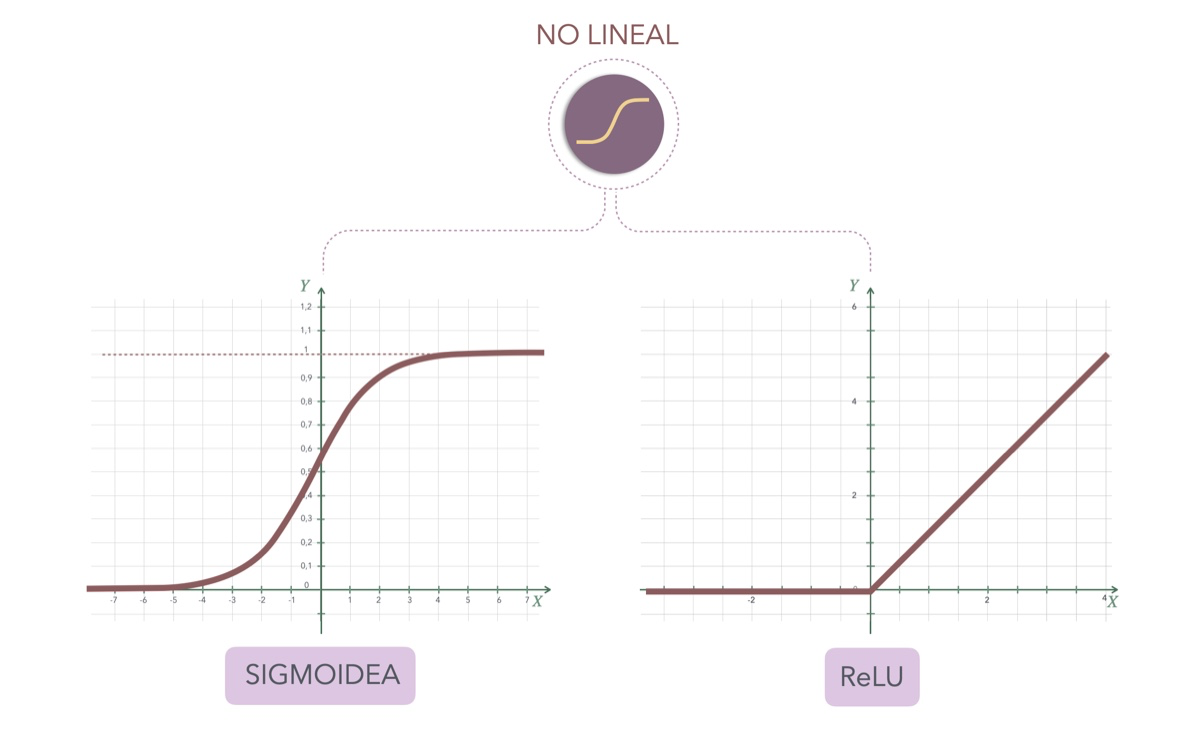
El motivo de usar funciones no lineales se sustenta en la necesidad de contar con modelos que nos ayuden a aprender las relaciones complejas que observamos en los datos, complejidad que es norma cuando trabajamos con datos en el mundo real. Porque, ¿qué ocurre si tenemos un conjunto de datos de los que queremos aprender que no se pueden separar de manera efectiva con una recta como en el siguiente gráfico?

Podemos ver que una sola línea recta no separa de manera eficaz los datos. En estos casos decimos que la recta no se ajusta a los datos. Por lo tanto un solo perceptrón no será suficiente, necesitaremos una red más compleja si queremos ajustarnos a peculiaridad en los datos de entrenamiento. Si usásemos una red con dos perceptrones aún no podríamos ajustarnos a los datos. Veámoslo en el mismo ejemplo de antes:

Es evidente que ninguna recta por sí sola nos permitirá separar los datos representados en la gráfica. Pero si combinamos varios perceptrones (cada cuadro representaría un perceptrón en una capa oculta) conseguimos representar adecuadamente la distribución real de los datos y clasificarlos correctamente.

A través de combinarlos podemos representar una mayor variedad y complejidad de problemas, lo que nos permite aprender y modelar una gama más amplia de casos.
El Entrenamiento de una Red Neuronal
Antes de que una Red Neuronal pueda hacer su magia necesita que la entrenemos con cantidades considerables de datos. El entrenamiento de una red neuronal es el proceso en que la red aprende a realizar una tarea, como clasificar imágenes o hacer predicciones, ajustando sus parámetros. Durante el entrenamiento, la red recibe ejemplos de datos (entradas) junto con las respuestas correctas (salidas), compara su predicción con la respuesta esperada y ajusta sus pesos para reducir el error.
Al inicio del entrenamiento la Red comienza con valores aleatorios para esos parámetros, y el objetivo del proceso de entrenamiento no es otro que el de minimizar el error entre el output actual del modelo y la respuesta deseada, que variará según sea la tarea específica para la que estemos entrenando nuestra Red Neuronal.
La red aprende a partir de los datos de entrenamiento en un proceso iterativo. Los datos de entrada (inputs) pasan a través de la red, perceptrón a perceptrón, capa a capa, hasta llegar a la salida (output) en un proceso que se llama propagación hacia adelante (forward propagation).
Durante el entrenamiento es necesario que todos los datos pasen a través de la red extremo a extremo, desde la capa de entrada hasta la de salida. A cada ciclo completo del algoritmo de entrenamiento se le denomina una época (o epoch en inglés). Un ciclo completo implica que la Red haya visto y procesado todas y cada una de las muestras del conjunto de datos de entrenamiento de uno a otro extremo al menos una vez.
En muchas ocasiones este proceso se hace en varias iteraciones procesando subconjuntos o lotes de datos en cada iteración. En cada pasada se realizan ajustes de optimización sobre los parámetros de ese subconjunto o lote de datos.
El proceso de entrenamiento busca encontrar los valores para cada dial de cada capa que permitan reducir al mínimo el error en sus predicciones. A este proceso se le denomina retropropagación (backpropagation) ya que se propaga desde el error hacia atrás, desde la capa de salida hacia la de entrada. Durante ese proceso se calculan los gradientes del error con respecto a los pesos de cada capa. Estos gradientes son los indicadores de referencia que se usarán para ajustar los pesos en el proceso que se denomina Optimización.
Hay una parte importante de este proceso de optimización en que interviene un algoritmo de uso muy extendido que es el Descenso de Gradiente, pero esto lo dejaré para otra ocasión.
En resumen, las redes neuronales son modelos de machine learning que se inspiran en el funcionamiento del cerebro humano, capaces de aprender y mejorar a partir de los datos. A través de capas de neuronas artificiales denominadas perceptrones y utilizando algoritmos como la retropropagación, estas redes ajustan sus pesos internos para realizar predicciones cada vez más precisas. Desde reconocer imágenes hasta procesar lenguaje natural, su capacidad para modelar relaciones complejas las ha convertido en una herramienta clave en el desarrollo de la inteligencia artificial moderna.


